以前跑大模型,GPU经常干坐着——不是算力不够,是数据还没送到。训练时动辄上亿个小文件、TB级Checkpoint频繁写入,老式存储一卡顿,整片GPU集群就“饿”着等。这次阿里云在2026云栖大会上甩出的新一代CPFS,直接把这口“气”给顺了。实测数据显示:AI存储成本砍掉69%,模型启动快一半,GPU峰值利用率提了30%。说白了,就是让几千张卡别再排队领“口粮”,而是端上桌就开吃。
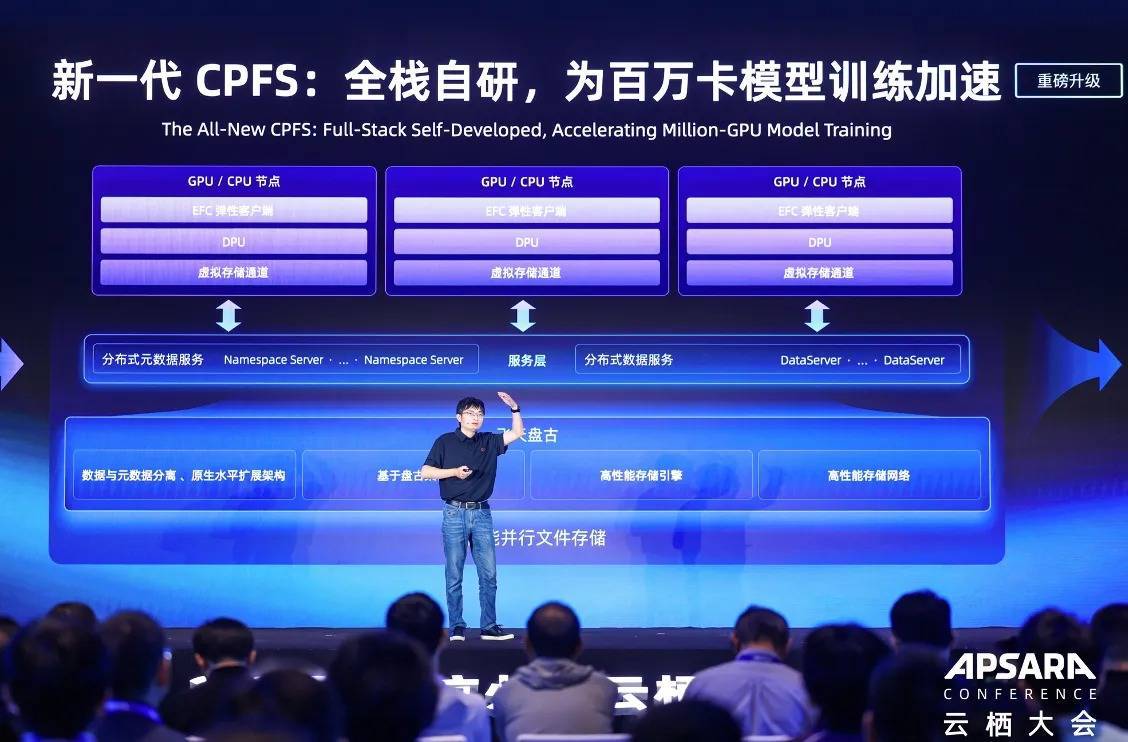
它怎么做到的?不是堆硬盘,而是全链路重造。CPFS用上了数据服务和元数据服务分离架构,单文件系统拉到100PiB(相当于10万TB),能稳稳扛住万亿级文件;吞吐飙到百TB/s,IOPS破亿——这数字听着虚,但落到Qwen3.8 Max这种超2T参数模型身上,就是训练周期缩短、实验迭代加快、试错成本变低。更实在的是冷热分层+智能生命周期管理,热数据走高速通道,冷数据自动沉底,钱花在刀刃上。
背后不是单点突破,而是一整套“存-算-平台”拧成一股绳。CPFS和灵骏智算集群、PAI平台深度打通,还配了KVCacheStore缓存引擎,专治长上下文、多轮对话这些让GPU反复“喘粗气”的场景。李飞飞说得实在:“我们从AI芯片、CPU、网卡、存储主控到软件栈,全自研、全协同。”这不是换个存储盒子,是把AI生产的“水电煤”整个升级了。
这种升级,普通人可能感受不深,但对AI公司来说,就是真金白银的账本在翻篇。以前跑一个大模型预训练,光是存储侧的运维人力就得配3~5个工程师盯IO、调缓存、救卡死;现在CPFS自带智能诊断和自动扩缩容,故障率下降76%,告警从每天几十条压到一周几条。有家做医疗多模态的创业公司试用后反馈:原来每周只能跑2轮实验,现在能推到5轮——不是人更拼命了,是系统不拖后腿了。
还有个容易被忽略的细节:CPFS支持原生POSIX语义,不用改代码、不换框架。PyTorch用户照常写Dataloader,TensorFlow团队继续用TFRecord,连Hugging Face的Trainer都不用动一行配置。这背后其实是阿里云把过去三年在通义实验室跑真实大模型时踩过的坑全填平了——比如Checkpoint写入时的锁竞争、多机多卡读取小文件的路径抖动、分布式训练中元数据爆炸增长……这些不是PPT里的“优化点”,而是工程师凌晨三点重启集群时的真实痛感。
更关键的是,它没把自己锁死在阿里云生态里。CPFS已通过CNCF认证,兼容Kubernetes CSI标准,能直接插进任何主流AI平台;去年底还开源了轻量级客户端libcpfs,GitHub上已有200+企业fork调试。一位头部自动驾驶公司的架构师私下说:“我们测试过三家云厂商的AI存储,CPFS是唯一能把Llama-3-405B模型微调任务从18小时压到11小时,且GPU利用率曲线始终平滑不掉坑的。”
说到底,AI竞赛早过了拼单卡算力的阶段。现在比的是谁先把“数据搬运工”换成高铁,让每张GPU都稳稳当当干活,而不是在等数据的路上反复熄火。CPFS不炫技、不堆参数,就干一件事:把AI训练里最磨人的“等待时间”,从分钟级压缩到毫秒级。而时间省下来,最后都会变成模型迭代的速度、产品上线的节奏、甚至是一家公司活下去的窗口期。
晶顶网配资提示:文章来自网络,不代表本站观点。